RRDESK
Техподдержка
Все публикации подряд на Хабре
13.11.2026
[Перевод] The history of Kubernetes
В современной ИТ-инфраструктуре невозможно переоценить роль Kubernetes — платформы с открытым исходным кодом для оркестрации контейнеров, которая автоматизирует развертывание, управление и масштабирование контейнеризированных программных приложений и сервисов. Согласно отчету организации Cloud Native Computing Foundation (CNCF), Kubernetes является вторым по величине проектом с открытым исходным кодом в мире (уступая лишь Linux®) и основным инструментом оркестрации контейнеров для 71% компаний из списка Fortune 100. Чтобы понять, как Kubernetes удалось занять доминирующее положение на рынке облачных вычислений и микросервисов, необходимо обратиться к истории его создания.
Эволюция Kubernetes
Читать далее13.11.2026
Жизнь не должна оправдывать своё существование полезностью
Представьте молодого системного администратора. Возможно, ему двадцать лет, возможно, тридцать пять. Он приходит на собеседование, садится напротив человека, который уже лет пятнадцать занимается сетями, серверами и инфраструктурой. Его спрашивают, что такое VLAN. Он начинает путаться, пытается вспомнить определения, произносит что-то про разделение сетей, но не может объяснить разницу между access и trunk. Собеседующий смотрит на него с выражением человека, которому только что нанесли личное оскорбление. Иногда усмехается. Иногда демонстративно закатывает глаза. Иногда говорит: «И вы называете себя системным администратором?»
Собеседование заканчивается. Человек выходит на улицу, достаёт телефон и начинает искать информацию о VLAN. И, возможно, именно в этот момент его жизнь могла бы измениться. Не потому, что он получил работу. Не потому, что кто-то признал его способности. А потому, что рядом мог оказаться человек, который сказал бы ему: «Слушай, ты просто не понимаешь, как это работает. Давай объясню».
Так было со мной, я ездил на разные собеседования, в Москва сити на 47 этаж, в разные крупные компании типа depo, yandex, mail, в depo успел по работать сборщиком серверов. Но:
Теперь мне плевать.
Я пишу статьи спустя 15 лет с того момента как их читал. Мне плевать на DEPO, на MAIL, на Yandex. Мне 34 года, и больше никогда в жизни не буду работать на кого-то чужого.
А когда свой текст правлю в нейросети на правки, chatgpt говорит ты слишком в своих статьях вспыльчив и это вредит твоему образу и мешает продвигать коммерческие проекты. Из коммерческого у меня в Левокумском чистка кулеров если что.
Читать далее13.11.2026
Vibe‑hacking Wi‑Fi камеры с помощью Claude
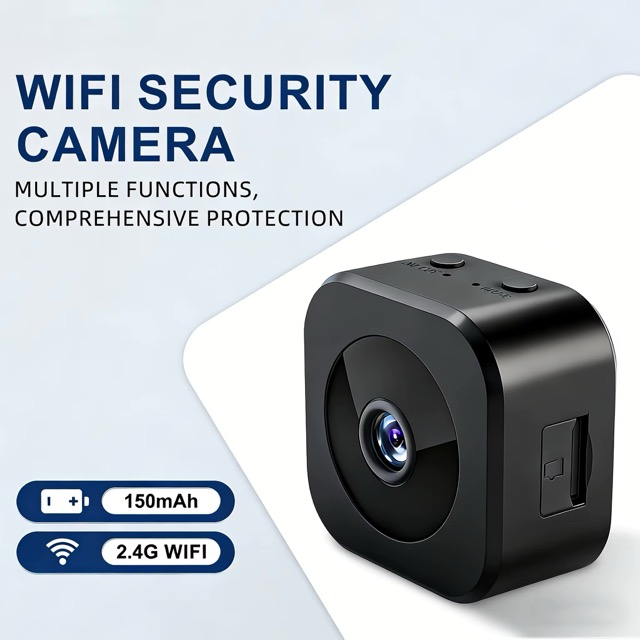
Однажды мне захотелось организовать на своем участке видеонаблюдение. С этими мыслями я забрел на известный китайский сайт и нашел там вот такую камеру.
Читать далее13.11.2026
3 базы данных в Docker за один вечер: PostgreSQL 18 + ClickHouse 26.8 + Qdrant 1.19
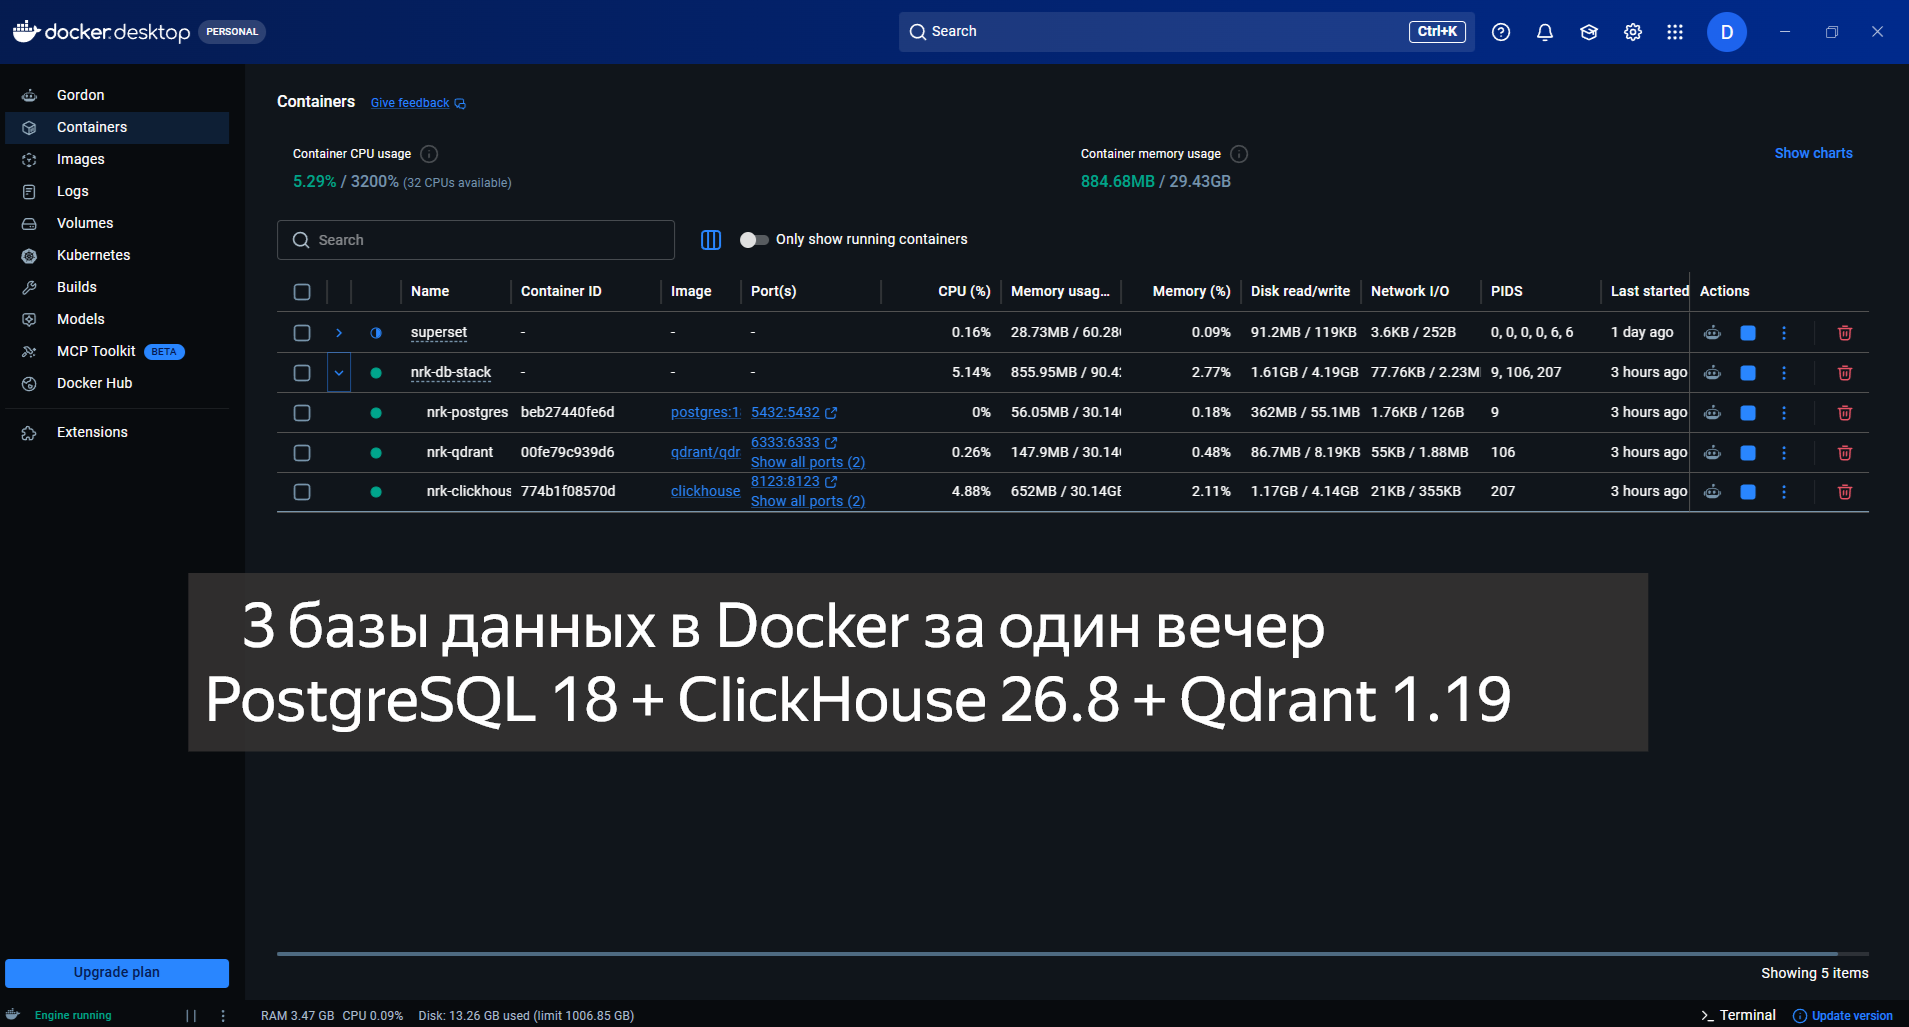
TL;DR: Поднял локально полный аналитический стек - реляционная БД, OLAP-аналитика и векторный поиск для RAG. Всё в одном compose-файле, данные - на томах WSL, ноль облачных счетов. Под катом - установка за три шага и три ловушки, о которых молчат гайды.
Читать далее13.11.2026
Мы проверили 500 сайтов малого бизнеса Перми и Екатеринбурга: что ломают зарубежные сервисы
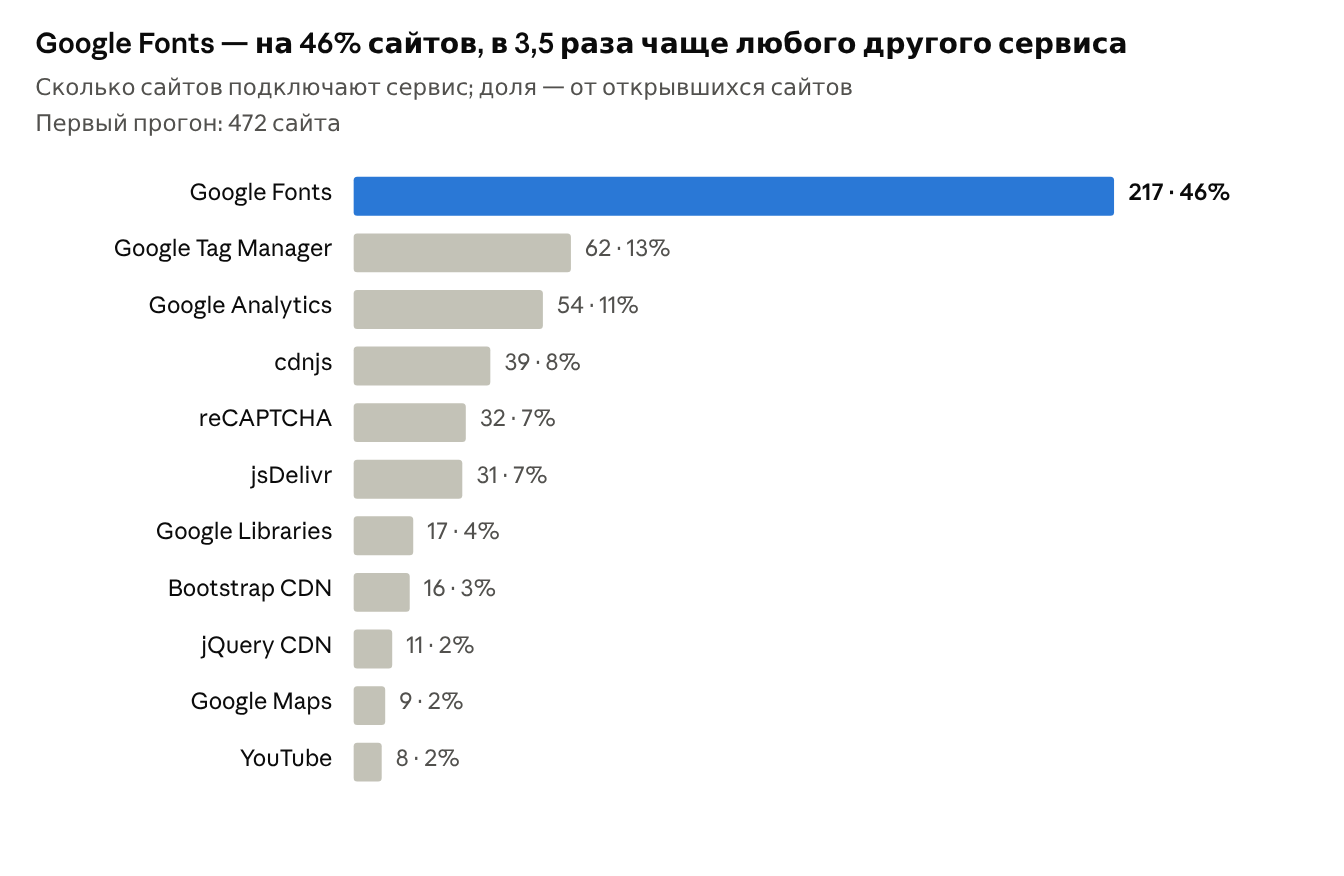
Две трети сайтов малого бизнеса Перми и Екатеринбурга (63%) подключают зарубежные сервисы: шрифты, аналитику, библиотеки, капчу, видео. На каждом восьмом сайте (12%) это заметно мешает посетителю из России: часть страницы не загружается или сайт открывается на секунды дольше.
В ноябре 2026 года мы открыли 500 сайтов так, как их открывает обычный посетитель, и записали каждый запрос. Ниже — что нашли, что на самом деле ломается и как владельцу сайта это исправить за вечер.
Читать далее13.11.2026
Клодизмы. Часть 1. Классификация ошибок, которые языковая модель допускает в связном тексте
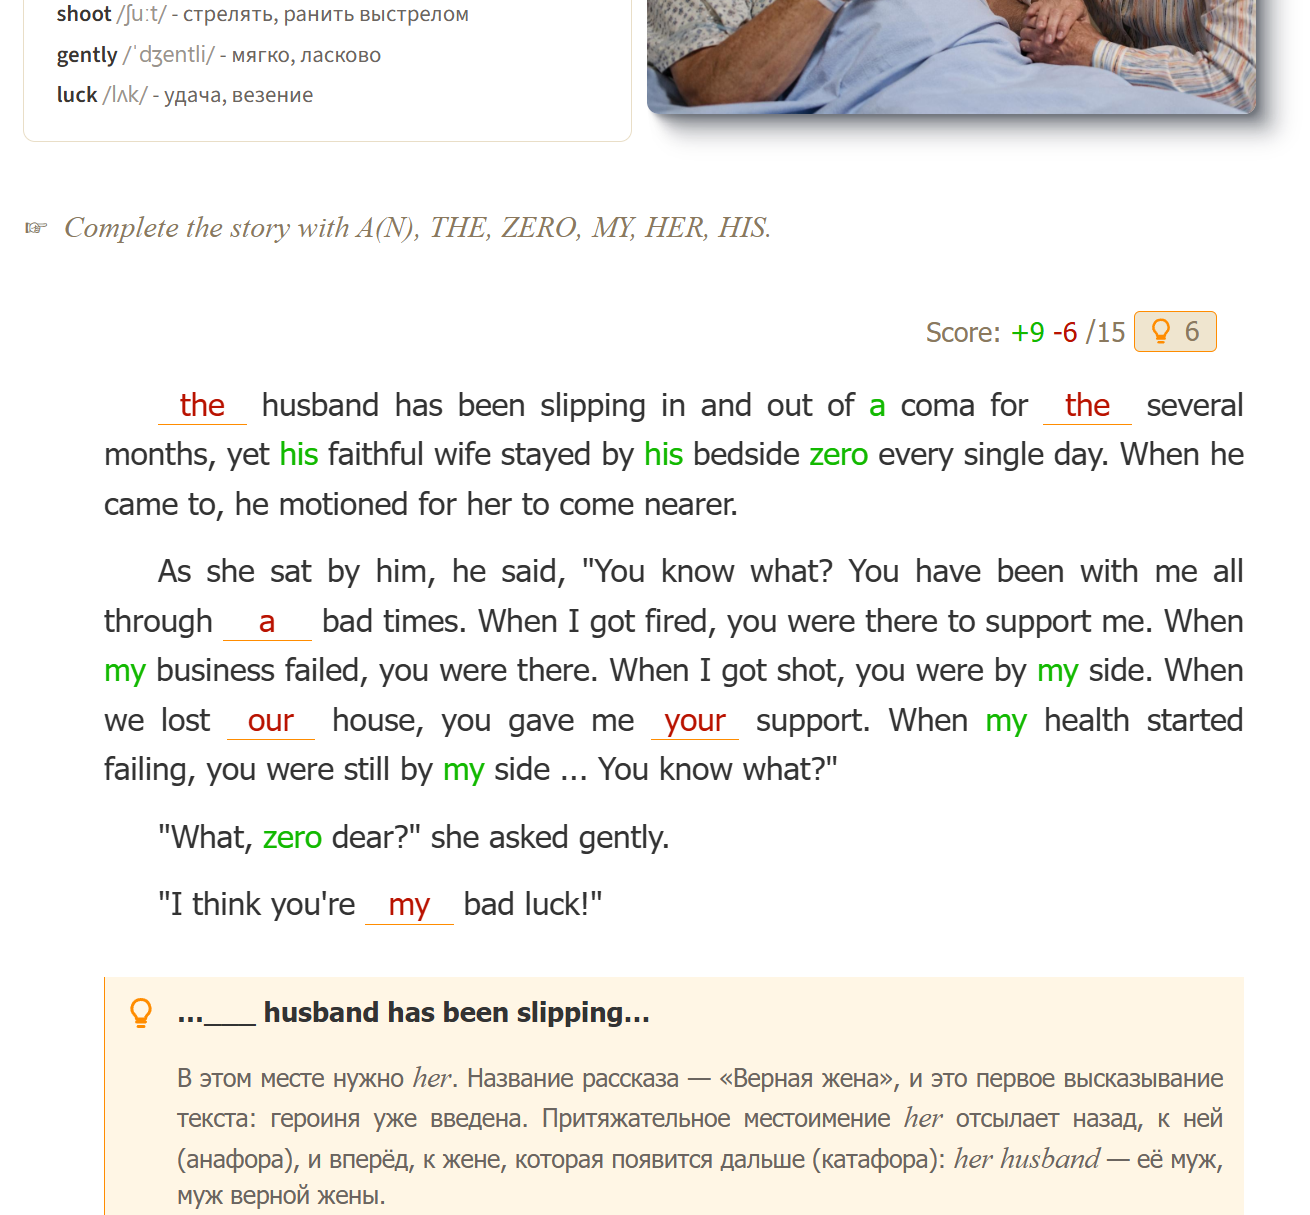
Я преподаю английский язык с 1989 года и веду сайт e-repa.ru: упражнения для русскоязычных учеников, построенные на собственных js-движках. О самих js-движках я писал в отдельной серии (часть 1, часть 2). Тексты к упражнениям — объяснения, преамбулы, методические записки — я пишу вместе с Claude. За несколько месяцев такой работы у меня накопился длинный список ошибок, которые модель повторяет из текста в текст с таким постоянством, что я называю их клодизмами.
Как такой список возникает, покажу на примере одного задания.
Читать далее13.11.2026
Три месяца я задавал нейросетям одни и те же 61 вопрос: доля ответов со ссылкой на мои статьи выросла с 3 до 51%
С середины лета я раз в несколько недель задаю нейросетям с веб-поиском одни и те же вопросы про франшизы и производство одежды и записываю, на какие страницы они ссылаются. Вопросы такие, какие задаёт человек перед покупкой: «за сколько окупается франшиза производства мерча», «как проверить франшизу, чтобы не нарваться на развод», «какой DTF-принтер выбрать для старта». Параллельно все эти месяцы я писал статьи о нашем производстве на открытые площадки, где публикуются сторонние авторы, и вёл блог компании.
На постоянной выборке из 61 вопроса, в которых наша компания не названа, доля ответов, где процитирована хотя бы одна наша страница, выросла за три месяца с 3 до 51 %. Сейчас это называют GEO-оптимизацией, то есть работой на то, чтобы попадать в ответы генеративного поиска, и я хотел проверить, работает ли она вообще, на своих данных. Ниже код замера, таблицы из прогона 13 ноября 2026 года и четыре места, где замер врёт или врал раньше. Без них эти 51 % ничего не стоят.
Читать далее13.11.2026
Делаю аналог codespell для русского языка
Всем привет! Я начал делать аналог codespell, только для русского языка!
Если кратко: codespell помогает находить опечатки в коде и файлах разных форматов, а мне такая потребность пригодилась при чтении и переводе оригинальной документации Python на русский. Проект называется sanya.
Идея простая: загружаем словарь возможных опечаток, проходимся по словам в проверяемых файлах и смотрим, есть ли слово в этом словаре. Пока что поддерживаются не все форматы файлов (только .po файлы) но главная проблема не в этом.
Сейчас в словарике около 4 тысяч слов, но для русского языка это мелочи. Например, у codespell в словаре около 65 тысяч слов. Поэтому проекту нужны активные контрибьюторы.
Если хотите дополнить словарик, отправляйте пулл‑реквесты: достаточно предложить слово, в котором может быть допущена ошибка. Это отличная возможность поучаствовать в проекте с открытым исходным кодом, даже если вы не программист, то можно просто предложить слово, в котором часто допускают ошибку:‑)
Кстати, не забудьте поставить звёздочку на GitHub
Читать далее13.11.2026
Как мы возрождаем Ксин: восстанавливаем боёвку по архивам и собираем бестиарий из Wayback Machine
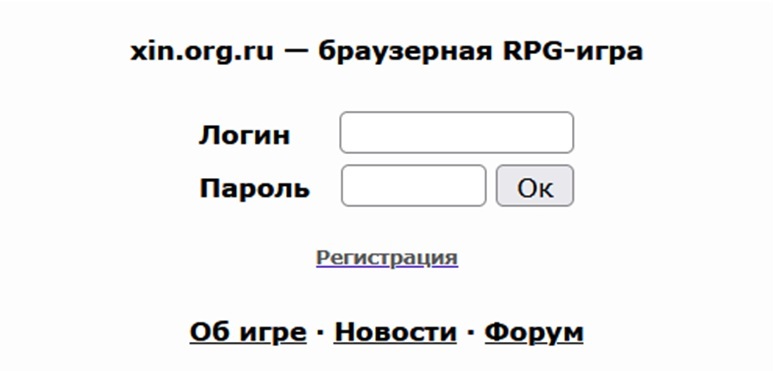
В середине нулевых в рунете была игра Ксин, браузерный MUD без единой картинки, только текст, HTML‑формы и таблицы характеристик. Через несколько лет проект умер: сервер выключили, исходники потерялись, остался только форум с обсуждениями механик и кэш в Wayback Machine. Мы собираем игру заново, не «игру по мотивам», а максимально точную реконструкцию: те же формулы, те же монстры, те же предметы.
Ниже не питч и не анонс, а рассказ о том, как это устроено технически: откуда брать данные, когда архиву верить нельзя, и что случилось один раз, когда мы ему поверили не глядя.
Читать далее13.11.2026
Вывод масс кварков и лептонов (продолжая Койде)
В данной статье мы ставим целью вывести из простых соотношений массы кварков и лептонов (не нейтрино, массы нейтрино не известны точно). Зато для оставшихся 9 чисел вы потребуем точность в процент - при том, что они отличаются на пять порядков. И да, в чем то это нумерология. Но формула Койде тоже нумерология... Поехали!
Читать далее13.11.2026
Paprium: почему я считаю его посредственной поделкой, раздутой маркетингом (мое субъективное мнение, прошу это учесть)
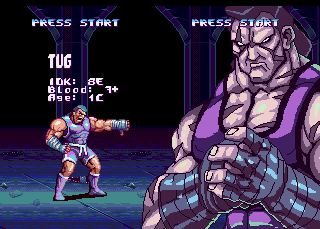
Десять лет разработки, сотни тысяч долларов краудфандинга, закрытые предзаказы, массивный радиатор на плате и легенды о «неэмулируемом суперчипе» внутри. Именно так публике продавали Paprium для Sega Mega Drive — пока в октябре 2026 года энтузиасты не вырезали этот чип патчем и не запустили игру на обычной приставке.
Читать далее13.11.2026
Мы делили апельсин (или не делили?) — разбираемся в различиях GPU Passthrough и vGPU
Еще лет пять назад графические ускорители в стойке выглядели как экзотика и весьма специфическое решение для узкого круга задач вроде тяжелого рендеринга или специфических научных расчетов. Теперь же с их помощью успешно решают задачи локального обучения нейросетей, аналитики видео и развертывания мощных виртуальных рабочих мест.
Однако физический GPU спроектирован как монолитное устройство для параллельных вычислений. В отличие от процессора и оперативной памяти, его нельзя просто так «нарезать» на части стандартными программными методами гипервизора. Из-за этого видеокарту сложно использовать эффективно — если отдать ее целиком одной ВМ под небольшую задачу, остальная часть ресурсов может простаивать, а распределить свободные мощности между соседними виртуальными машинами без специальных технологий не получится.
Чтобы решить эту проблему, инженерам приходится выбирать между двумя принципиально разными подходами — GPU Passthrough и vGPU. Ниже мы подробно разберем, как устроены эти технологии, в чем их реальные различия и что выбрать под конкретные сценарии и типы нагрузок.
Читать далее